Post-training quantization using second-order information for model compression
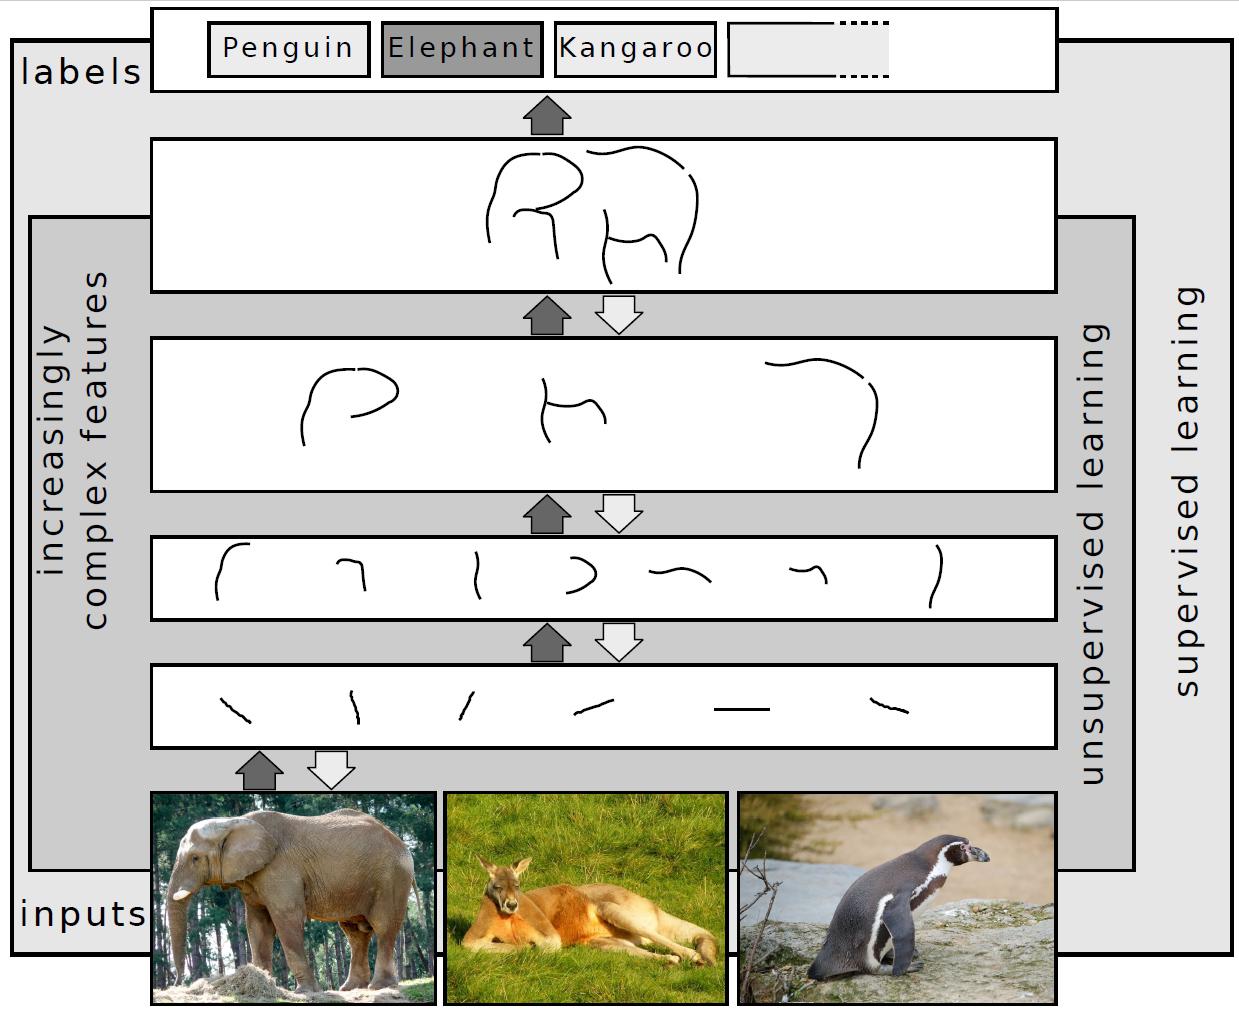
Image: Sven Behnke, CC BY-SA 4.0, via Wikimedia Commons
GPTQ quantization does
Post-training quantization using second-order information for model compression
Related concepts
AWQ does differently
AWQ selectively retains weights crucial for model performance, unlike traditional quantization
Federated learning
Ever wonder how to train a smart device without sharing your personal data?
GPTQ vs AWQ: GPTQ uses Hessian-based quantization, AWQ preserves activation-important weights
GPTQ applies Hessian-based quantization, AWQ retains weights crucial for activations
quantization to INT8 doubles throughput
Quantization to INT8 doubles throughput because tensor cores process INT8 2x faster
Vector quantization
How can you store a huge library of books in a tiny closet?
Shannon's source coding theorem: you can't compress below entropy
Can you squeeze endless text into fewer bits without losing anything?
Swipe through more Machine Learning concepts
Open Pocket Polymath